如果你想在手机上读一本扫描书,理想的结果不是多了一个 EPUB 文件,而是能调大字号、连续读下去,不用每翻一页就放大和左右拖动。目录应能带你找到章节,脚注和插图也应留在能理解的位置。PDF 转 EPUB 可以帮你得到这样的阅读文件,但前提是文字能被识别,章节与段落的顺序也能保留下来。
先确定你要保留什么
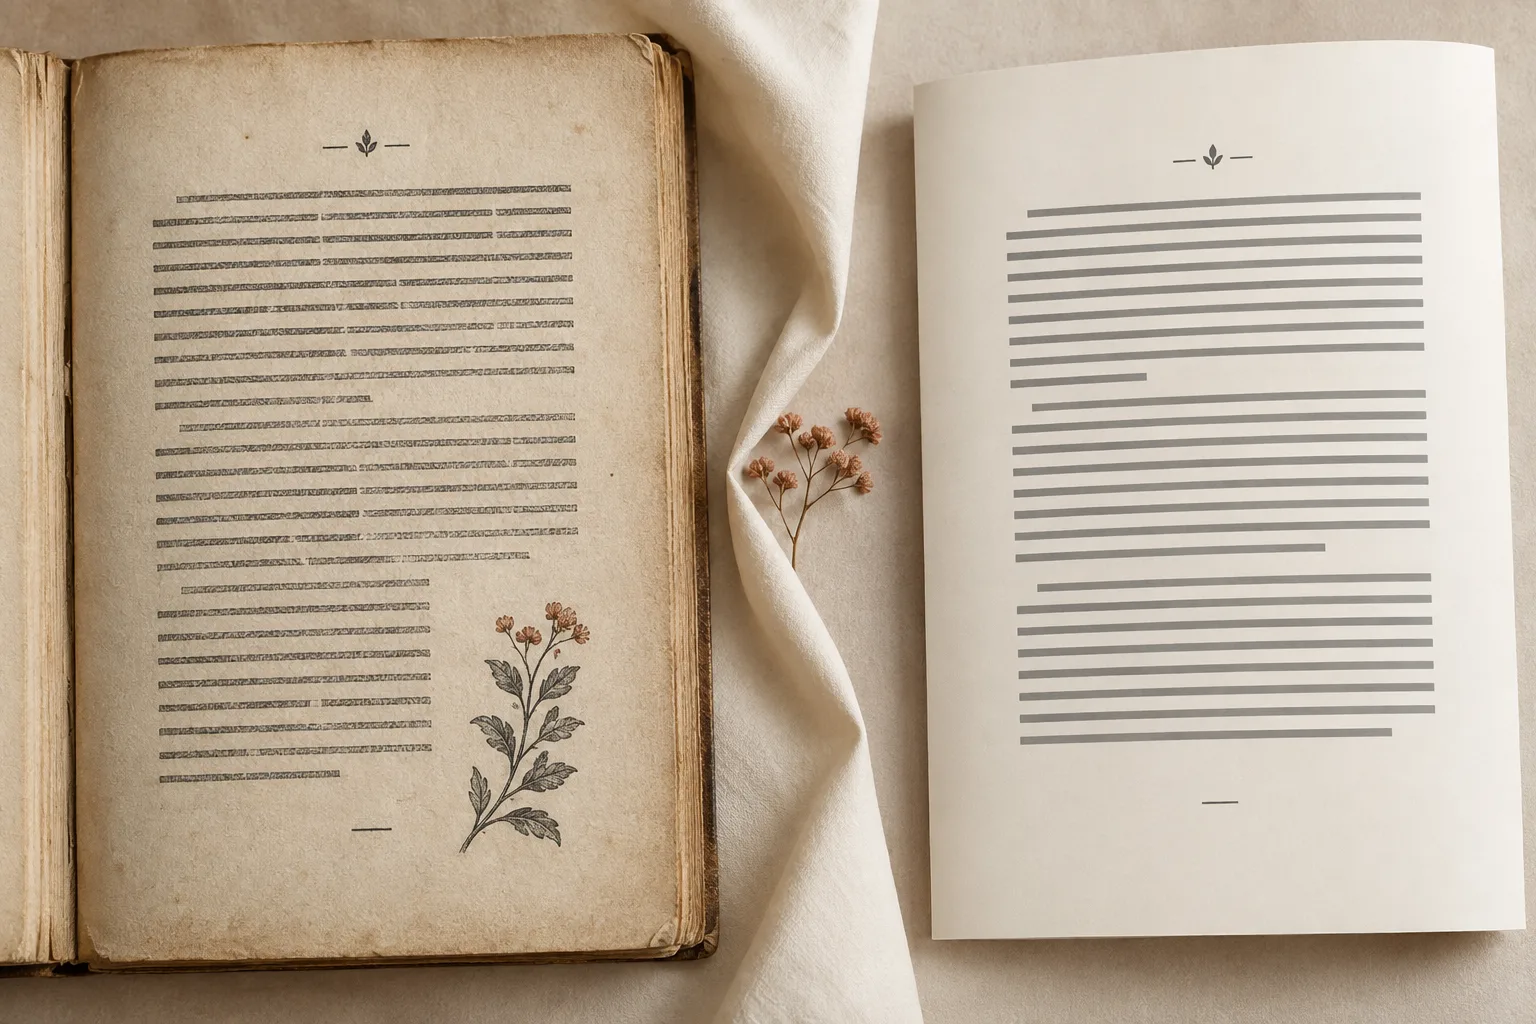
PDF 适合保留固定页面,流式 EPUB 更适合调整字号后继续阅读。EPUB 标准也允许固定版式,因此不能仅凭扩展名判断一本书是否可以自由重排。
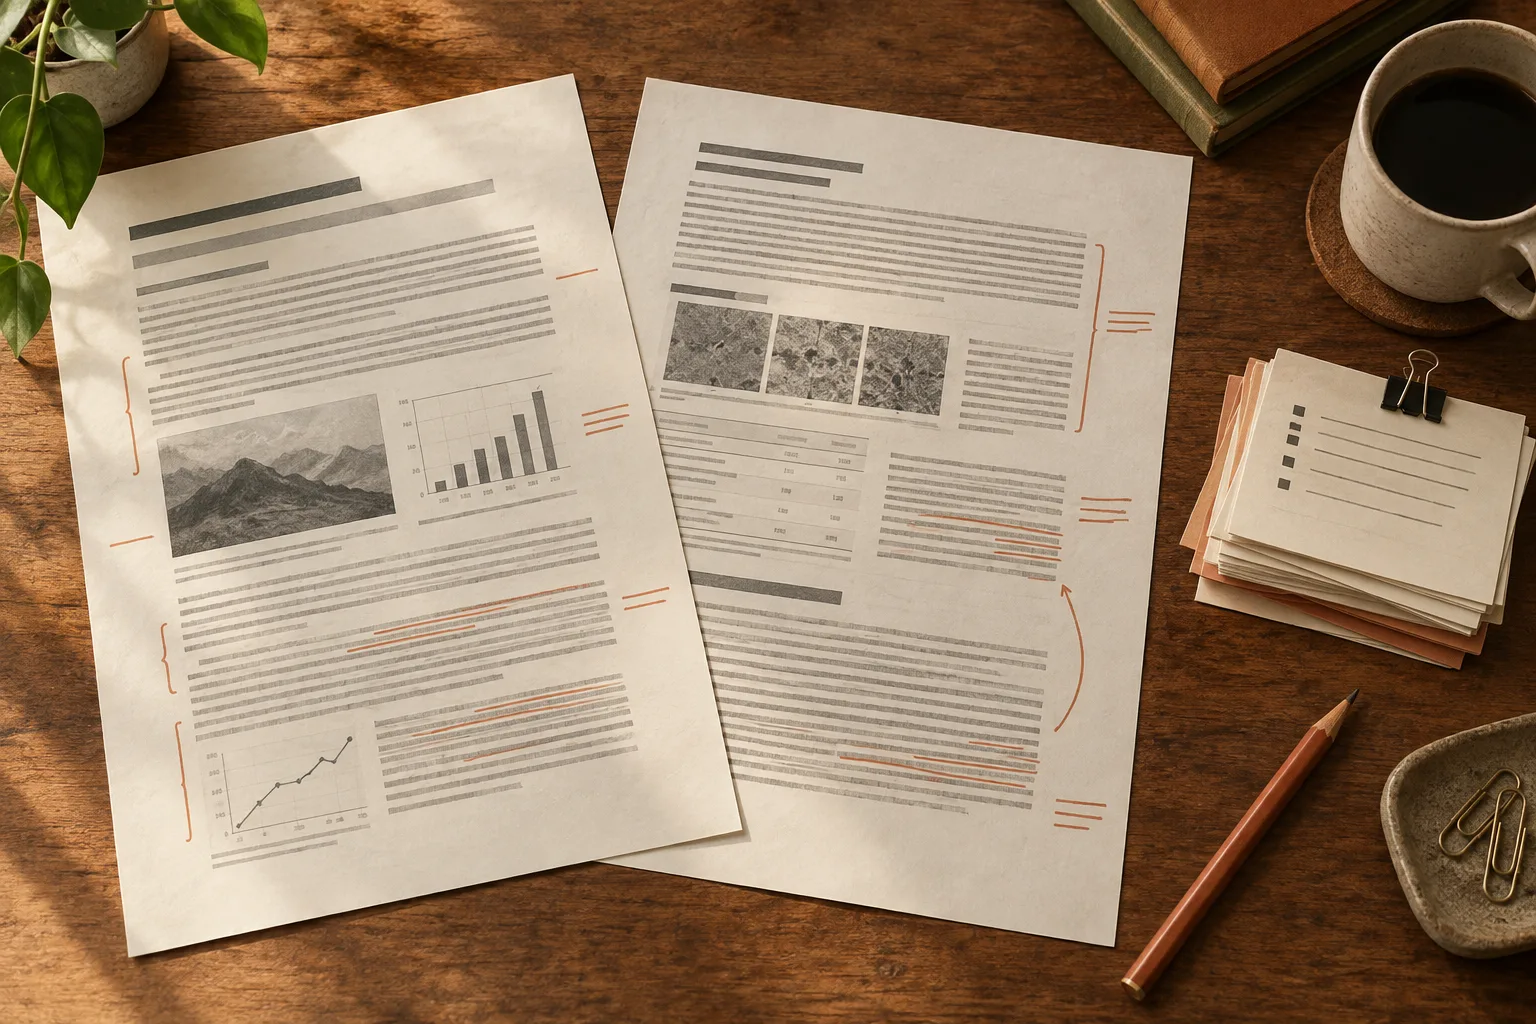
小说、以正文为主的教材,通常更看重阅读连贯性,适合尝试流式 EPUB。插图与标注位置紧密关联的手册,即使转换成 EPUB,也要保留 PDF 对照原页。先想清楚自己需要舒适阅读,还是必须看到原来的页面位置,才能判断转换结果是否合用。
判断源文件需要哪些处理
尝试选中一段文字:如果只能选中整块图片,通常需要先做文字识别(OCR)。即便能选择文字,也要复制一段检查是否乱码、缺字或顺序混乱。PDF 里已有可选文字,也不一定表示它能正确使用。
至少检查章节开头、普通正文、最复杂的一页。注意书脊阴影、倾斜、裁掉的页边、模糊小字和跨页段落。优先使用清晰原件;单纯放大低分辨率图片不会自动找回已经丢失的细节。
用有代表性的文件试转换
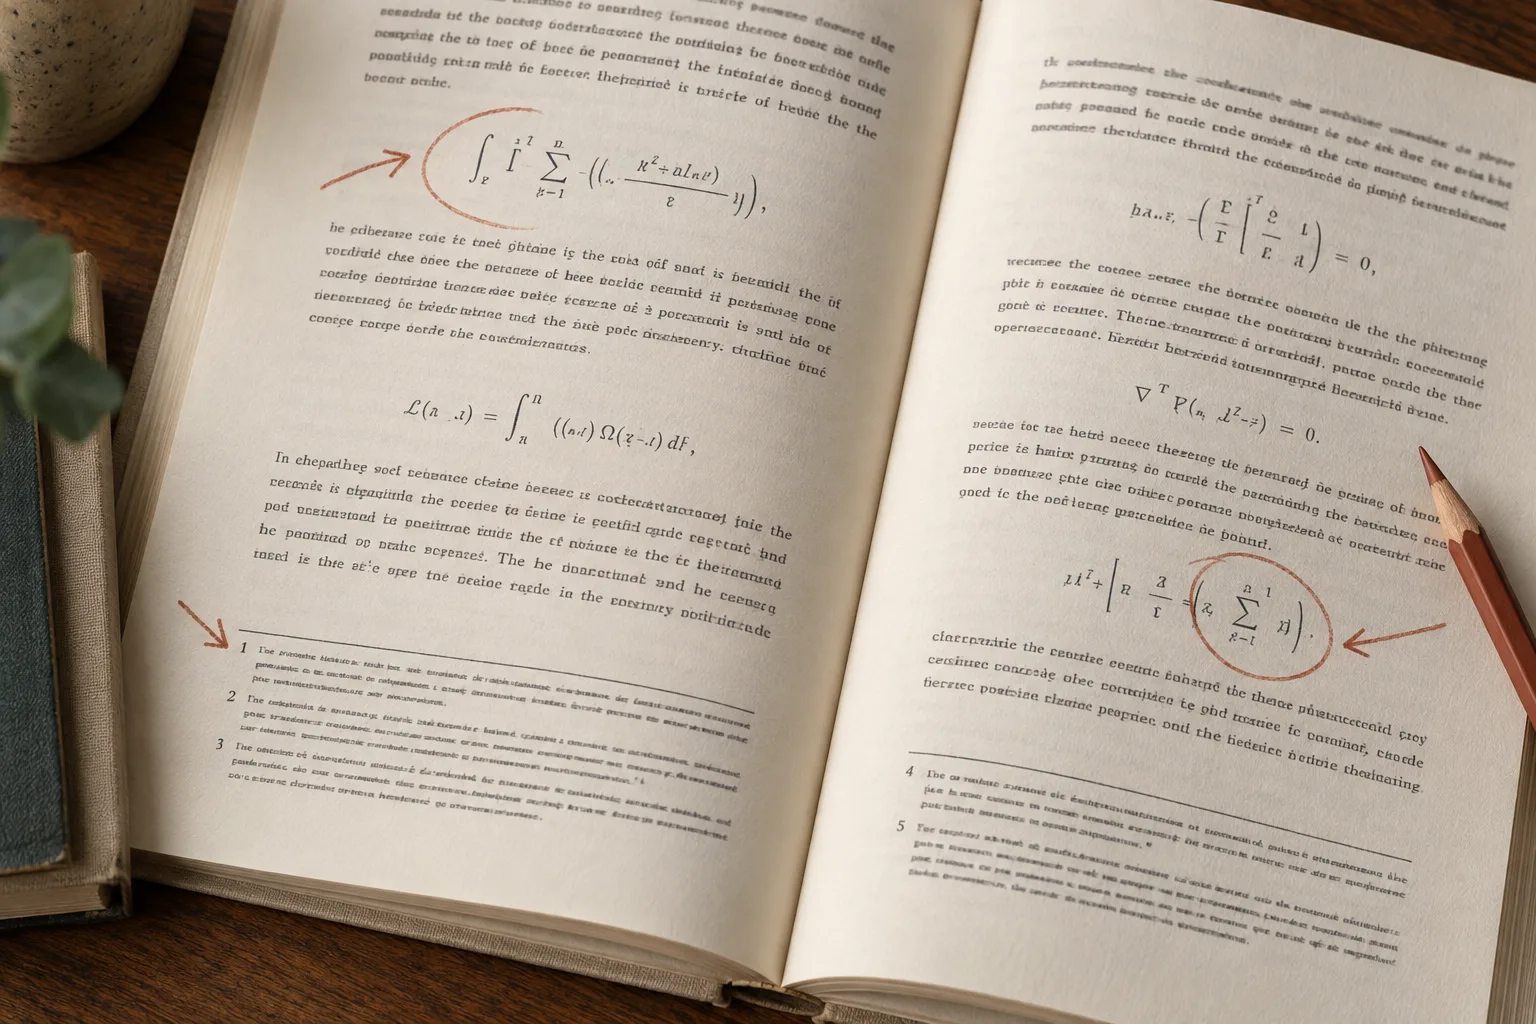
在 PDF Craft 转换页面选择 EPUB 输出。如果要处理一批书,先选一本较短、但包含典型难点的书试转;如果只有一本书,先转换文件,再重点验收其中一章。书里有脚注、表格或公式,验收的章节就应包含这些元素,不要只看封面和前几页。
PDF Craft 将识别和文档转换放在同一流程中,目标是得到可以继续阅读的产物,而不是一份松散的文字堆积。扫描质量和复杂排版仍会影响结果,不能把“任务完成”理解成“识别完全正确”。如果目的是编辑段落和整理笔记,可以先看 PDF 转 Markdown 指南。
在你常用的阅读器里试读一章
打开 EPUB,把字号调到平时阅读的大小,连续读一章。先看是否还要横向滚动、目录能否定位到章节,再看标题、插图和说明是否仍在合适的位置。
把原 PDF 放在旁边,对照读过一处原书分页位置。特别留意页眉混入正文、跨页断词、左右两栏文字串在一起,以及脚注标号错配。读完后确认:
- 抽查章节的开头和结尾都在。
- 段落顺序和原书一致。
- 关键人名、数字、符号没有明显错误。
- 调大字号后不需要持续横向滚动。
- 注释与插图仍能找到对应正文。
根据试读结果决定下一步
如果试读时有大量错字,先找更清楚的扫描件;如果字都对、段落却读不通,回看原页的分栏和转换设置;如果内容正确、只是显示异常,再换阅读器复核。一本书试读合格后,再用相同标准处理同类资料。若关键脚注或公式反复出错,保留 PDF 阅读这些页面可能比继续转换更合适。
flowchart TB
  accTitle: 从试读一本书到处理同类资料
  accDescr: 先检查扫描件并转换文件,再试读其中一章。通过后处理同类资料;不通过就定位扫描、结构或显示问题。
  A[检查扫描件] --> B[转换文件并试读一章]
  B --> C{阅读器验收通过?}
  C -- 是 --> D[处理同类资料]
  C -- 否 --> E[定位问题并调整]
  E --> B
保留原件作为引用依据
流式排版会改变文字在屏幕上的位置,EPUB 页码不一定对应印刷页码。做摘录时记录原书版本和原 PDF 页码,不要只保留转换后的阅读位置。
如果试读的一章仍需要大量修正,先改善扫描质量或继续使用 PDF,再投入更多书籍的处理。技术类资料可以继续使用公式与脚注检查清单。好的转换结果,应当既读得下去,也查得回原文。