如果你要从一篇技术论文中摘录公式、引用脚注或使用表格数据,转换后的文件必须让你得出与原文相同的意思。一个负号、单位或脚注标记出错,都可能改变结论。验收时先找这些会影响理解和引用的错误,再处理字体、间距等显示问题,才能知道产物是否可以用来阅读或做笔记。
先弄清错误发生在哪一步
OCR 是从扫描图像中读出文字和结构;如果还要翻译,翻译处理的是识别后的内容。先把原页、识别结果和译文放在一起看:下标在识别时就丢了,应先处理原件或识别结果;原式正确、译文解释错了,才是翻译问题。
PDF Craft 提供文档识别与转换流程,也有与公式、脚注有关的处理选项。保留公式应理解为尽量保留已识别的表达,不是保证原扫描中的每个符号都正确。复杂资料可以先在 PDF 转换页面处理样本,再决定是否继续翻译。
对照原图逐项核符号
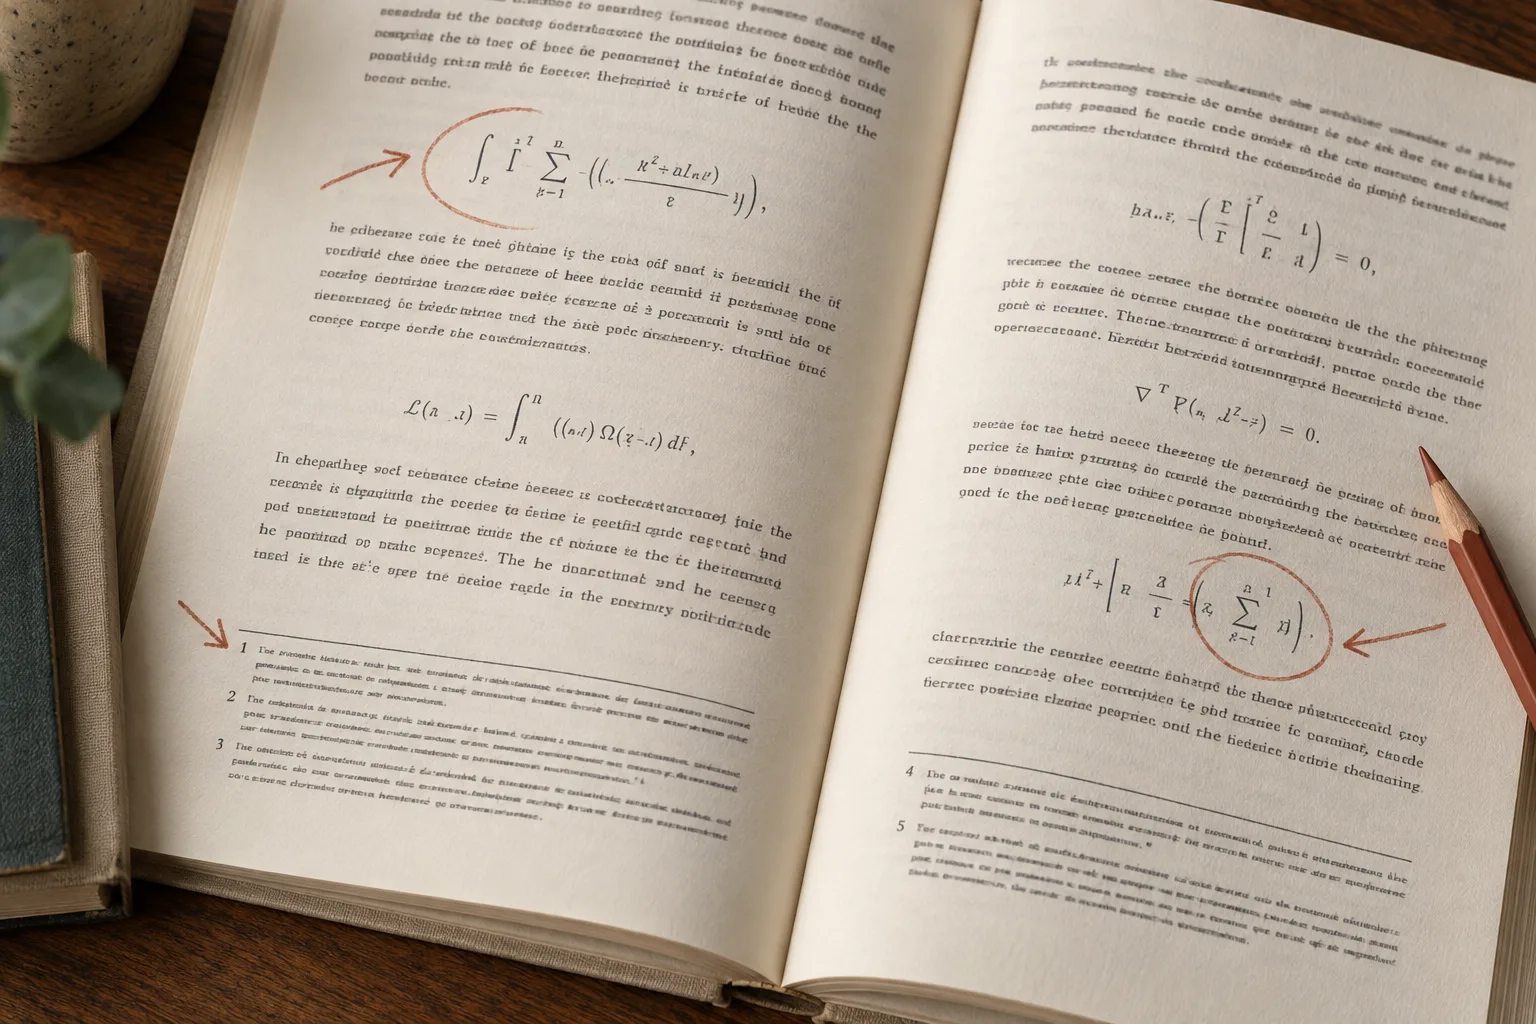
从你真正要使用的章节,挑一条包含上下标、分数、希腊字母或求和范围的公式,与原页图像逐符号比较。不要只和自己记忆中的公式比较。
特别注意数字 0 与字母 O、数字 1 与小写 l、乘号与字母 x。检查括号是否配对、负号是否存在、小数分隔是否正确,以及公式编号有没有混入表达式。还应在实际阅读器或编辑器中预览,区分“内容识别错了”和“工具不支持这种数学表示”。
从正文追到脚注,再返回
脚注是标记与说明之间的对应关系。抽查几处正文标记,找到完整注释,再确认编号和含义能够对应。
页脚可能混入正文,较短的注释可能丢失,长注释也可能在分页处被截断。即使链接可以点击,也要读一下连接的内容。根据任务决定是否保留脚注:研究材料中的注释可能包含论述限定或引用来源,并非都可省略。
检查表格与双栏顺序
连续读过一处跨栏段落,确认输出没有在左栏未结束时跳到右栏。抽查表格值时同时看行标题、列标题和单位,只看数字是不够的。
| 原文位置 | 要使用的内容 | 核对内容 | 出错后的处理 |
|---|---|---|---|
| 论文第 8 页 | 一条用于推导的公式 | 负号、下标、求和范围 | 改变推导时,先回原页核对 |
| 引用所在页 | 脚注 | 标记是否指向完整注释 | 指错来源时,暂停引用 |
| 数据表所在页 | 要摘录的数据 | 数值、行列标签、单位 | 错列或单位错误时,修正后再用 |
表格应填写真实观察结果,不要把几个抽查点换算成没有依据的“全文准确率”。
按对阅读和引用的影响处理问题
给发现的问题记下原 PDF 页码、产物位置和影响。如果符号或单位改变了结论、脚注指错来源、段落跨栏乱序,先修正或重新处理;如果内容正确、只是显示不正常,先换阅读器验证。关键公式或引用无法与原页核对时,暂停正式引用这份产物。抽查能帮你发现风险,不能替代对全文的审核。
flowchart TB
  accTitle: 技术文档的错误分流
  accDescr: 挑复杂页与原 PDF 对照。影响含义的符号、脚注或顺序错误先修正;只有显示问题时先换阅读器验证,最后再决定是否接受。
  A[挑一页复杂内容] --> B[与原 PDF 核对]
  B --> C{影响含义或引用?}
  C -- 是 --> D[修正或重新处理]
  C -- 否 --> E[换阅读器复核]
决定接受、修订还是重做
如果错误集中在模糊、变形的页上,优先寻找更清楚的来源;如果表达正确而显示异常,先换工具或格式验证,再决定是否重新处理。
用于笔记时参考 Markdown 整理流程,用于阅读时参考 EPUB 转换指南。公式、脚注和引用承载主要含义时,始终保留原 PDF 供复核。